1. Qué riesgo corre una empresa que usa IA
El riesgo concreto se ve en tres escenas que ocurren todas las semanas en empresas que ya usan IA: un asistente responde con seguridad un dato equivocado y el cliente lo toma como verdad; un agente pega en una planilla un dato personal que no debía salir del sistema; una decisión —un descuento, una prioridad de atención— se toma y nadie puede explicar de dónde salió. Ninguna de las tres es ciencia ficción: son fallas de proceso con una herramienta nueva.
La evidencia acompaña. El AI Index de Stanford registró 233 incidentes de IA documentados en 2024, un 56,4% más que el año anterior y el máximo de la serie. Y el mismo informe señala que las organizaciones reconocen los riesgos —precisión, cumplimiento, ciberseguridad— pero muchas todavía no toman medidas activas para mitigarlos.
Por eso la conversación útil no es sobre ética en abstracto sino sobre control: qué puede hacer el sistema, con qué datos y quién responde cuando falla. Una empresa que puede responder esas tres preguntas está en condiciones de escalar. La que no puede, está acumulando riesgo a cambio de velocidad.
2. Los cinco riesgos que importan
De la lista larga de riesgos posibles, cinco tienen consecuencia real para una empresa mediana. Los demás son variantes de estos.
| Riesgo | Cómo se manifiesta | Control mínimo |
|---|---|---|
| Respuesta falsa con seguridad | El sistema inventa un precio, un plazo o una norma y lo afirma sin dudar | Que consulte la fuente y cite; si no puede citar, no responde |
| Datos personales expuestos | Se envía al modelo información de clientes que no hacía falta | Minimizar campos, contrato con el proveedor y registro de qué se envió |
| Decisión sin explicación | Un puntaje define prioridad o descuento y nadie sabe cómo se calculó | Criterios documentados y revisión humana en la decisión final |
| Dependencia del proveedor | Cambia el precio, el modelo o la política de uso y el proceso se detiene | Poder cambiar de modelo sin reescribir el proceso |
| Uso interno sin control | Cada área contrata su herramienta y pega datos de la empresa | Inventario de herramientas y una regla única de qué se puede subir |
El quinto es el más subestimado y el más común. En una empresa de 200 personas es normal que haya ocho herramientas de IA en uso y ninguna declarada. El problema no es la herramienta: es que nadie sabe qué información salió de la empresa. El inventario se hace en una planilla y se actualiza una vez por trimestre.
3. Qué exige la ley y qué conviene hacer igual
Tres marcos ordenan la conversación hoy: el reglamento europeo, el marco voluntario de Estados Unidos y la ley argentina de datos personales. No hace falta cumplir los tres al pie de la letra, pero sí conocer qué pediría cada uno si mañana hubiera una auditoría.
| Marco | Qué exige | Qué implica para una empresa |
|---|---|---|
| Reglamento europeo de IA (AI Act) | Clasificar cada sistema por nivel de riesgo, documentarlo y cumplir obligaciones crecientes | Inventario por caso, evaluación antes de usar y registro de decisiones |
| NIST AI RMF (Estados Unidos) | Gobernar, mapear, medir y gestionar el riesgo de cada sistema | Un método simple para poner nombre y dueño a cada riesgo |
| Ley 25.326 (Argentina) | Base legal, finalidad, consentimiento y seguridad en el tratamiento de datos personales | Definir qué datos puede ver el sistema y cuáles nunca |
| Recomendación de UNESCO | Dignidad humana, transparencia y supervisión humana en todo el ciclo | Criterio para lo que la ley todavía no cubre |
El reglamento europeo entró en vigencia el 1 de agosto de 2024 y escalona sus obligaciones: las prácticas prohibidas rigen desde febrero de 2025, las reglas para modelos de propósito general desde agosto de 2025, los sistemas de alto riesgo del Anexo III desde el 2 de agosto de 2026 y los integrados en productos regulados desde agosto de 2027. Las multas llegan hasta 35 millones de euros o el 7% de la facturación global, lo que sea mayor, para las prácticas prohibidas.
Para una empresa argentina que no vende en Europa, el valor del reglamento es distinto: funciona como guía de lo que un cliente corporativo o un fondo va a pedir en cualquier due diligence. Adoptar su lógica de clasificación cuesta poco y ahorra una discusión cada vez que se firma un contrato grande.
4. Cómo se clasifica el riesgo de un caso
Antes de construir, cada caso se ubica en uno de tres niveles. La clasificación no es burocrática: define cuánto control humano lleva el proceso y quién lo aprueba.
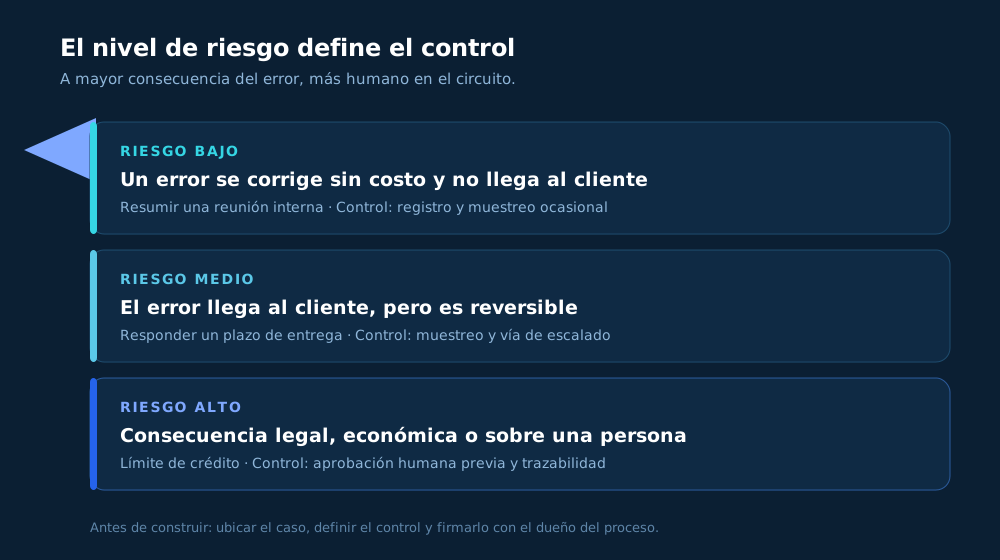
Riesgo bajo: un error se corrige sin costo y no llega al cliente. Ejemplo: resumir una reunión interna. El control es registro y muestreo ocasional.
Riesgo medio: el error llega al cliente pero es reversible. Ejemplo: responder por WhatsApp un plazo de entrega. El control es revisión por muestreo y una vía de escalado clara.
Riesgo alto: el error tiene consecuencia legal, económica o sobre una persona. Ejemplo: decidir un límite de crédito o negar una cobertura. El control es aprobación humana previa, documentación de criterios y trazabilidad completa.
5. Cómo se controla en la práctica
El control se sostiene con cuatro piezas, y ninguna requiere un área nueva: un inventario, una regla de datos, un registro de ejecuciones y un responsable.
- Inventario de casos. Una planilla con cada sistema en uso, qué decide, qué datos ve, quién es el dueño y en qué nivel de riesgo está. Se revisa por trimestre.
- Regla de datos. Una lista corta de lo que nunca se envía a un modelo externo —documento, salud, datos de tarjeta, contratos— y otra de lo que se envía solo con contrato y minimización.
- Registro de ejecuciones. Qué entró, qué salió, qué modelo se usó y quién aprobó. Es lo que permite reconstruir un incidente sin adivinar.
- Responsable con nombre. Alguien que responde por el conjunto, no solo por su área. Sin nombre, todos suponen que alguien más lo está mirando.
La pieza que más rápido devuelve valor es la segunda. La mayoría de los incidentes evitables no ocurre por un modelo sofisticado: ocurre porque alguien pegó en un chat una planilla con datos de clientes para «que la ordene». Una regla clara y una alternativa interna resuelven el 80% de esos casos.
6. Un caso: atención con datos personales
Un agente de atención que responde por WhatsApp necesita tres datos para resolver: número de pedido, estado del envío y saldo. No necesita el historial clínico del cliente, ni su número de tarjeta, ni la conversación completa con otro agente. El primer control es técnico: la herramienta que consulta la base devuelve solo esos tres campos, no toda la ficha.
El segundo control es de proceso: si el cliente pide algo que requiere un dato sensible, el agente deriva a una persona en lugar de resolverlo. Y el tercero es de registro: cada consulta queda guardada con la identificación del pedido, sin el contenido completo del mensaje, para poder auditar sin acumular datos innecesarios.
Con esas tres piezas, el caso pasa de riesgo alto a riesgo medio y se puede poner en producción. Sin ellas, es un canal que expone información y que nadie puede auditar después. La diferencia no está en el modelo: está en qué se le permite consultar y qué queda escrito.
¿Querés revisar el riesgo de los casos de IA que ya tenés en marcha? Escribime y armamos el inventario y la clasificación.
Escribime un mail7. Qué exigirle al proveedor
Cuatro preguntas separan a un proveedor serio de uno que vende una demo. Se hacen antes de firmar y las respuestas van por escrito.
- ¿Los datos que te envío se usan para entrenar? La respuesta tiene que ser no, y tiene que estar en el contrato.
- ¿Dónde se procesan y cuánto se retienen? País de procesamiento, plazo de retención y cómo se borran.
- ¿Puedo exportar el registro de ejecuciones? Si el historial queda solo del lado del proveedor, la empresa no puede auditar nada.
- ¿Qué pasa si cambio de modelo o de proveedor? Si la respuesta es «hay que rehacer todo», la dependencia es el riesgo principal de ese contrato.
La cuarta pregunta es la que casi nadie hace y la que más caro sale. Un proceso construido con el modelo atado a la herramienta se convierte en rehén de cada cambio de precio.
8. La prueba: control sobre lo que corre
En los sistemas que opero, el control no es un documento: está en el código. Cada ejecución deja registro; las notas que no alcanzan un umbral de calidad no se publican; los agentes que vigilan el servidor avisan cuando algo se sale de rango. Cuando una nota sale mal, se puede reconstruir qué versión, qué modelo y qué revisión intervinieron.
Ese esquema —umbral, registro y derivación a humano— es el mismo que necesita una empresa para cumplir cualquiera de los marcos de arriba. No hace falta empezar por la política: alcanza con que el primer caso en producción tenga registro y un responsable con nombre. La política se escribe después, cuando ya hay algo real que describir.
La conclusión práctica: el riesgo de la IA se gestiona con las mismas herramientas que el riesgo operativo de siempre —inventario, dueño, registro, revisión— aplicadas a un sistema que además puede equivocarse con seguridad. Quien ya sabe hacer eso en su operación, tiene media guía hecha.
Fuentes
- Unión Europea — Reglamento (UE) 2024/1689, Reglamento de Inteligencia Artificial (vigente desde el 1 de agosto de 2024).
- Comisión Europea — Regulatory framework on AI (calendario de aplicación y sanciones).
- NIST — AI Risk Management Framework (enero de 2023; funciones gobernar, mapear, medir y gestionar).
- Stanford HAI — AI Index 2025, capítulo Responsible AI (abril de 2025; 233 incidentes en 2024, +56,4%).
- Argentina — Ley 25.326 de Protección de los Datos Personales (2000).
- UNESCO — Recommendation on the Ethics of Artificial Intelligence (noviembre de 2021).
Preguntas frecuentes
¿El reglamento europeo de IA me aplica si estoy en Argentina?
Aplica a quien pone en el mercado europeo un sistema o a quien usa en la Unión Europea un resultado producido por IA. Si tu empresa vende en Europa, o tus clientes están ahí, conviene tratarlo como propio: el estándar de documentación que exige es hoy el más exigente y sirve como base para cualquier auditoría.
¿Puedo usar IA con datos de clientes?
Sí, con condiciones: base legal para el tratamiento, finalidad informada, minimización —mandar solo los campos necesarios— y un contrato con el proveedor que prohíba usar esos datos para entrenar sus modelos. En Argentina eso se apoya en la Ley 25.326 de protección de datos personales.
¿Quién es responsable si el sistema se equivoca?
La empresa que lo usa. El proveedor responde por su producto, pero la decisión de ponerlo en contacto con un cliente es de quien lo contrata. Por eso el control humano en el último paso y el registro de ejecuciones no son un lujo técnico: son la defensa.
¿Alcanza con un documento de política de IA?
No. Una política sin inventario de casos y sin registro de ejecuciones es una declaración de intenciones. Sirve para mostrar compromiso; no sirve para responder una auditoría ni un reclamo.
¿Qué hago con las alucinaciones?
Darle al sistema fuentes verificables en lugar de memoria: que consulte la base, el documento o la API, y que cite de dónde sacó el dato. Si no puede citar, la respuesta no se publica. Es la diferencia entre un asistente y un generador de riesgo.