1.Qué separa un caso que funciona de uno que se apaga
Un caso de IA en producción se reconoce por una cosa: sigue corriendo al cuarto mes, con volumen real y con alguien mirando un tablero. No importa si el modelo es el más nuevo ni si la demo fue espectacular. Lo que distingue a los casos que aguantan es que el proceso cambió, el sistema tiene dueño y el resultado se mide con el mismo número todos los meses.
Los números del mercado explican por qué la mayoría no llega ahí. El informe del MIT sobre IA en las empresas (2025) encontró que cerca del 95% de los pilotos de IA generativa no produce impacto medible; Gartner proyecta que más del 40% de los proyectos de agentes se cancelará hacia fines de 2027; y McKinsey muestra que, aunque el 62% de las organizaciones experimenta con agentes, solo el 23% escaló alguno. La brecha entre experimentar y operar es el tema de esta guía.
Un ejemplo de la diferencia. Un ecommerce que pone un chatbot para responder «¿dónde está mi pedido?» tiene un caso que funciona si la respuesta sale del estado real del envío y no de una plantilla. Si el agente improvisa un plazo, el caso se apaga en dos semanas: el cliente reclama, el equipo de atención lo desconecta y nadie lo vuelve a encender. La tecnología era la misma; cambió si estaba conectada a la verdad.
2.Las cinco condiciones de producción
Antes de escalar un piloto conviene chequear cinco condiciones. Si falta una, el sistema puede funcionar hoy y romperse en el mes tres, cuando cambia el volumen, el proveedor del modelo o la persona que lo operaba.
| Condición | Qué significa | Cómo se nota cuando falta |
|---|---|---|
| Dato verificable | La respuesta sale de una fuente que se puede consultar, no de la memoria del modelo | Inventa plazos, precios o stock con total seguridad |
| Umbral de calidad | Un número define cuándo el resultado es aceptable | Cada revisión es una opinión distinta del mismo caso |
| Dueño operativo | Una persona responde por el sistema en el organigrama | Cuando falla, todos miran a sistemas; cuando funciona, nadie lo mantiene |
| Costo acotado | Tope de consumo y alerta por desvío | Una factura del modelo que triplica el presupuesto en un mes |
| Plan de salida | Se puede volver al proceso anterior en días | El sistema se vuelve un rehén: nadie se anima a apagarlo |
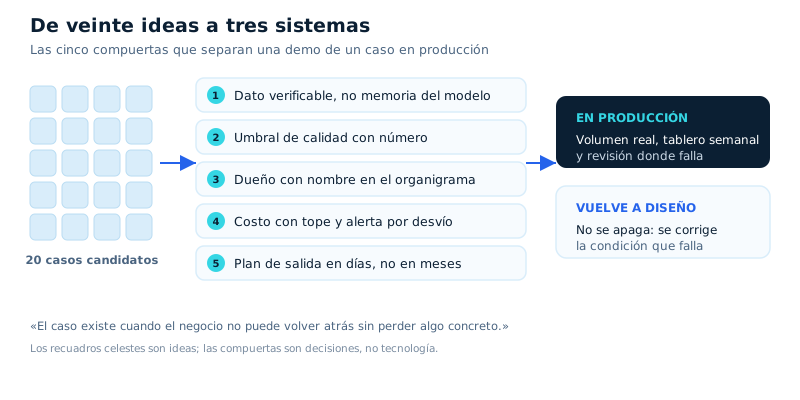
La condición que más se saltea es el umbral de calidad, y es la que hace la diferencia entre un sistema y una discusión eterna. Definir «aceptable» con un número —el 92% de las respuestas sin corrección, el 98% de los campos bien cargados— permite decidir si el sistema mejora o empeora sin convocar una reunión. Sin umbral, cada caso raro reabre el debate sobre si la IA sirve.
3.Los cuatro casos que aguantan
Hay familias de casos que se repiten en empresas muy distintas y que resisten el paso a producción. No son las más ambiciosas: son las que tienen volumen, dato accesible y un resultado que se puede verificar sin discutir.
Atención y postventa con dato conectado. El agente responde estado de pedido, políticas y horarios consultando el sistema real. Funciona porque la respuesta correcta está en una fuente y el error se detecta con una comparación. En una operación de consumo masivo, esto reduce la cola de consultas repetidas y libera al equipo para los casos que requieren criterio.
Producción de contenido con revisión. El sistema investiga, redacta y adapta; una persona aprueba. Es el caso del pipeline editorial que corre en Motor Digital Press: cuatro sitios, 780 notas publicadas, 14 agentes y un umbral de calidad que decide qué se publica y qué vuelve a revisión. Aguanta porque el humano está en el punto exacto donde el error se vuelve caro.
Back office documental. Extraer datos de facturas, remitos, contratos o formularios y cargarlos en el sistema. Es el caso con mejor retorno medido en empresas medianas: alto volumen, resultado verificable campo por campo y errores que se corrigen en el momento. También es el menos vistoso, y por eso el que menos se vende.
Monitoreo y scouting. Agentes que rastrean fuentes, detectan cambios y avisan. Funcionan porque el resultado es un aviso, no una decisión: si el agente se equivoca, cuesta una revisión de más. En el ecosistema propio hay agentes que vigilan la salud del pipeline —VPS, jobs, disco, errores— y avisan antes de que el problema se vea en el sitio.
¿Tenés un piloto que no termina de arrancar? Escribime y vemos qué condición le falta para pasar a producción.
Escribime un mail4.Los tres que se caen
Los casos que fracasan tienen un patrón común: piden autonomía total sobre un proceso que todavía no está definido, o prometen predecir algo que la empresa no sabe medir. El primero es el agente de punta a punta: entra un pedido, investiga, decide, factura y avisa, sin intervención. Se cae porque cada eslabón suma error y el último paso —facturar— no admite corrección.
El segundo es la predicción con datos flojos: estimar demanda, churn o morosidad con un histórico incompleto o contaminado. El modelo devuelve un número con dos decimales y eso genera una confianza que los datos no sostienen. Antes de predecir hay que poder explicar cómo se construyó el histórico.
El tercero es el asistente para todo: un chat que responde sobre cualquier tema de la empresa. Sin alcance definido no hay forma de evaluarlo, y sin evaluación no hay mejora. Los proyectos que arrancan así suelen terminar como una herramienta que algunos usan, que nadie mide y que se renueva por inercia.
Hay una cuarta trampa que no es un caso sino una práctica: medir el éxito por adopción. Que 300 empleados hayan abierto la herramienta no dice nada sobre el resultado. La métrica de un caso en producción es la del proceso —tiempo, costo por caso, error— y la adopción es solo el requisito para que esa métrica exista.
5.La prueba: qué corre hoy y qué mide
Los casos que se pueden mostrar con nombre y número no son muchos, y ese es justamente el punto. En el ecosistema propio hay tres sistemas en operación con métricas comparables. El pipeline editorial de Motor Digital Press: cuatro sitios, 780 notas publicadas, 14 agentes, con un umbral de calidad y revisión humana donde el umbral no se alcanza. El hub de LaMoto: fichas estructuradas de cada modelo generadas de forma asistida, sin carga manual ficha por ficha. Y el conjunto de agentes de monitoreo: salud del pipeline, detección de tendencias y alertas antes de que el problema llegue al lector.
En los tres casos la estructura es la misma y es replicable: un proceso escrito, un dato accesible, un umbral numérico y un humano en el punto donde el error cuesta. Ninguno de los tres es un agente autónomo de punta a punta, y ninguno promete predecir nada. Son sistemas que hacen trabajo repetitivo con control.
La comparación honesta con el mercado: la mayoría de los casos que se presentan como «IA en producción» son un asistente con interfaz. Eso puede ser útil, pero no cambia un proceso. Cambiar un proceso es lo que mueve el costo, y es lo que se puede auditar al mes siguiente.
Conviene además distinguir dos tipos de métrica que suelen confundirse en las presentaciones. La métrica de eficiencia —horas, costo por caso, tiempo de ciclo— responde si el sistema conviene. La métrica de calidad —aciertos, correcciones, reclamos— responde si el sistema se puede sostener. Un caso que mejora la primera y empeora la segunda está comprando velocidad con errores, y eso se paga más adelante en el mismo proceso o en atención al cliente.
6.Cómo pasar un piloto a producción
El pasaje no es un acto administrativo: es una serie de decisiones que se toman en orden. La más importante es achicar el alcance. Un piloto que funciona en un canal suele romperse al abrirse a todos, no porque el modelo empeore sino porque aparecen casos que nadie previó.
- Congelá el alcance en un canal, sucursal o tipo de caso, y documentá qué queda afuera.
- Escribí el umbral de calidad y el procedimiento cuando no se alcanza: quién revisa, en cuánto tiempo y qué se registra.
- Conectá el dato a la fuente real antes de escalar volumen. Si la respuesta depende de una planilla que alguien actualiza a mano, ese es el primer punto de falla.
- Abrí el volumen de a 25% y mirá el tablero cada semana: aciertos, costo por caso y derivaciones a humano.
- Nombrá al dueño y dejá por escrito qué hace cuando el sistema falla un viernes a la noche.
El error más caro en esta etapa es escalar por presión interna en lugar de por dato. Cuando el volumen sube antes de que el umbral esté estable, el equipo empieza a corregir a mano lo que el sistema hace mal y el ahorro desaparece sin que nadie lo note. El tablero semanal es lo que evita esa trampa: muestra la relación entre volumen y correcciones.
Y una decisión que conviene tomar antes del lanzamiento: qué se hace con el proceso anterior. Dejarlo activo en paralelo dos semanas es razonable; dejarlo «por las dudas» seis meses es garantizar que nadie lo apague nunca y que la empresa pague dos veces por el mismo trabajo.
El último paso del pasaje es el más aburrido y el que más problemas evita: escribir cómo se opera el sistema. Qué revisa el humano, cada cuánto, qué alerta dispara qué acción y a quién se llama si algo se rompe un domingo. Un caso en producción sin ese documento depende de la memoria de la persona que lo armó, y esa persona tarde o temprano cambia de área.
Preguntas frecuentes
¿Cómo sé si mi piloto está listo para producción?
Si podés mostrar el número del proceso —tiempo, costo por caso o error— durante cuatro semanas seguidas y el dato sale de una fuente verificable, está cerca. Si todavía se mide por cantidad de consultas, no.
¿Cuánto tarda un caso en llegar a producción?
Entre 8 y 16 semanas en un proceso acotado de back office o atención: dos de línea de base, cuatro de piloto y el resto de escalado gradual por volumen.
¿Qué hago si el caso falla después del lanzamiento?
Primero mirá si falló el dato: la mayoría de las caídas vienen de una fuente desconectada o desactualizada. Después revisá si el volumen subió antes de que el umbral estuviera estable.
¿Sirve empezar por un agente autónomo?
No como primer caso. La autonomía total multiplica el costo del error y no hay registro que permita aprender. Conviene empezar con autonomía graduada: sugiere, después ejecuta con aprobación, y al final ejecuta solo con tope.
¿Vale la pena para una empresa que no es tecnológica?
Sí, y suele rendir más: los procesos de back office documental tienen volumen alto, reglas claras y resultados verificables campo por campo.
Fuentes
- Fortune — MIT report: 95% of generative AI pilots at companies are failing (agosto 2025, sobre State of AI in Business 2025 del MIT NANDA).
- Gartner — Over 40% of Agentic AI Projects Will Be Canceled by End of 2027 (junio 2025; costos crecientes, valor poco claro y controles insuficientes).
- McKinsey — The State of AI 2025 (noviembre 2025; 62% experimenta con agentes, 23% escaló alguno).