1.Qué significa «en producción» para un agente
Un agente está en producción cuando alguien de afuera depende de su respuesta para tomar una decisión, y cuando un error suyo tiene consecuencias que hay que reparar. Esa es la línea. No la marca la cantidad de usuarios ni la elegancia del prompt: la marca que si el agente se cae un martes a las 10, haya un cliente esperando y alguien responsable de contestar.
El dato que mejor dimensiona el salto lo dio Gartner en junio de 2025: más del 40% de los proyectos de IA agéntica se cancelará hacia fines de 2027 por costos crecientes, valor de negocio poco claro o controles de riesgo insuficientes. Traducido a la práctica: la mayoría no muere porque el modelo sea malo, sino porque nadie armó la parte que sostiene el sistema cuando el modelo se equivoca.
Un piloto se parece a un agente de producción en la demo y se diferencia en todo lo demás: quién revisa, qué pasa si falla, cuánto puede gastar, cómo se corrige y cómo se apaga. Ese es el contenido de las secciones que siguen.
2.Las cinco piezas que un prototipo no tiene
Un prototipo necesita un modelo, un prompt y un caso de prueba. Un sistema en producción necesita cinco piezas más, y cada una responde a una forma concreta de romperse.
| Pieza | Qué resuelve | Cómo se ve en la práctica |
|---|---|---|
| Set de evaluación | Saber si un cambio mejora o empeora | 50 casos reales con la respuesta esperada, versionados en un archivo |
| Trazabilidad | Entender por qué respondió lo que respondió | Un registro por paso con id de conversación, herramienta usada y tokens |
| Guardrails | Evitar acciones con consecuencias | Techo de gasto, máximo de pasos, lista de acciones que requieren aprobación |
| Versionado | Poder volver atrás en un minuto | Prompt, modelo y herramientas con número de versión y flag de apagado |
| Runbook y guardia | Que alguien sepa qué hacer cuando falla | Tres pasos escritos: cómo verificar, cómo apagar, a quién avisar |
De las cinco, la que más se saltea es el set de evaluación, y es la que más barata sale. Sin casos guardados, cada ajuste de prompt es una apuesta: el equipo cambia una frase, prueba tres conversaciones a mano y concluye que «quedó mejor». Con 50 casos, el cambio se mide en dos minutos y con el mismo criterio que la semana anterior.
3.El ciclo de vida: del prototipo al canary
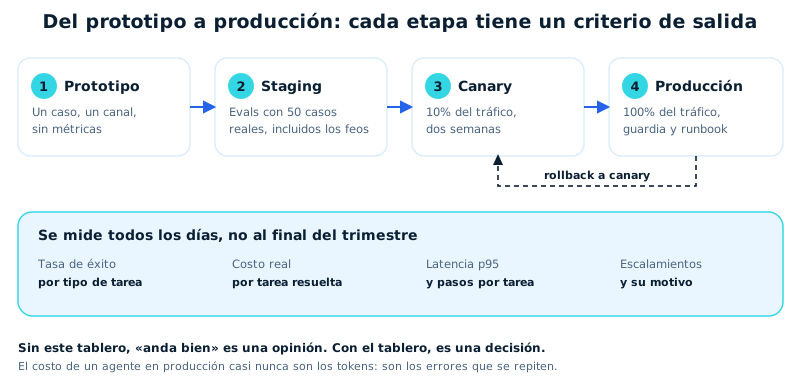
Un agente no debería estrenarse con todo el tráfico. La forma probada de moverlo es por etapas, y cada etapa tiene un criterio de salida que se define antes de entrar.
| Etapa | Qué se prueba | Criterio para pasar a la siguiente |
|---|---|---|
| Prototipo | Un caso, un canal, respuestas revisadas a mano | Resuelve el caso simple y las herramientas responden |
| Staging | Set de 50 casos reales, incluidos los difíciles | Acierta la acción correcta en al menos 9 de cada 10 casos sin inventar datos |
| Canary | 10% del tráfico real durante dos semanas | Métricas iguales o mejores que el resto del tráfico, sin incidentes abiertos |
| Producción | 100% del tráfico, con guardia y tablero | Revisión semanal de métricas y del set de casos nuevos que fallaron |
La etapa canary es la que se saltea por apuro y la que evita el desastre. En un agente de atención, el 10% del tráfico real alcanza para encontrar el problema que ningún set de prueba anticipa: el cliente que escribe en mayúsculas y con el pedido en una captura de pantalla, o el que responde con un audio.
4.Qué se mide en producción (y qué se ignora)
En producción se mide lo que permite decidir: si el agente mejora, si se puede ampliar y cuánto cuesta. La cantidad de «conversaciones atendidas» no decide nada; el costo por tarea resuelta, sí.
| Métrica | Qué mide | Uso concreto |
|---|---|---|
| Tasa de éxito por tipo de tarea | Casos resueltos sin corrección humana, separados por motivo | Decide qué tarea ampliar y cuál sigue en manos de personas |
| Costo por tarea resuelta | Modelo, herramientas e infraestructura dividido por casos cerrados | Justifica o frena la ampliación con un número propio |
| Latencia p95 | El tiempo del 5% más lento, no el promedio | Detecta el cuello de botella real: suele ser una herramienta externa |
| Pasos por tarea | Cuántas llamadas al modelo y a herramientas hizo falta | Un promedio que sube semana a semana anuncia un loop o un prompt confuso |
| Escalamientos por motivo | Por qué pasó la conversación a una persona | Define la próxima función a construir |
El marco de referencia para esta parte no hay que inventarlo: las prácticas de confiabilidad de Google SRE aplican igual a un agente que a un servicio web, incluido el concepto de presupuesto de error, que convierte «cuánto puede fallar» en una decisión de negocio y no en una discusión de opiniones. Y si el agente toca datos personales o decisiones sobre personas, el Marco de Gestión de Riesgos de IA del NIST ofrece la estructura mínima para documentar qué se midió y qué se decidió.
¿Tenés un agente trabado en la etapa de demo? Escribime y armamos el camino a producción con métricas y guardrails.
Escribime un mail5.Los cuatro modos de falla que más cuestan
Los agentes no fallan de formas exóticas. Fallan de cuatro maneras, todas previsibles, y cada una tiene una defensa concreta que cuesta menos que el incidente.
La herramienta equivocada. El agente llama a la función de cancelar pedido cuando el cliente preguntaba por el estado. Se defiende con permisos por tipo de acción y con confirmación explícita para todo lo que escribe datos. El loop. Reintenta la misma herramienta porque el resultado no le sirve, y consume tokens hasta que alguien mira la factura: se corta con un máximo de pasos y un techo de gasto por conversación.
La deriva silenciosa. El proveedor cambió el formato de la respuesta de una API y el agente empezó a devolver «no encontré tu pedido» sin error visible. Se detecta con un chequeo diario que hace una consulta conocida y compara el resultado. La contención falsa. El agente cierra la conversación con un «listo» que no resolvió nada y el cliente vuelve a las 48 horas; se mide con la repetición por tema y no con la cantidad de chats cerrados.
6.Un caso con números: 400 conversaciones por día
Para que el costo deje de ser una abstracción, un ejemplo trabajado con supuestos explícitos. Un agente de atención recibe 400 conversaciones diarias, hace 6 llamadas al modelo por conversación, con 4.000 tokens de entrada y 500 de salida cada una. A precios de gama media de 0,50 dólares por millón de tokens de entrada y 1,50 por millón de salida, el cálculo es el siguiente:
- Entrada: 400 × 6 × 4.000 = 9,6 millones de tokens por día → 4,80 dólares.
- Salida: 400 × 6 × 500 = 1,2 millones de tokens por día → 1,80 dólares.
- Total del modelo: 6,60 dólares por día, unos 198 dólares por mes.
Si el agente deriva el 35% de las conversaciones, resuelve 260 por día: el costo baja a 2,5 centavos por conversación resuelta de punta a punta. Sumando 30% por plataforma y herramientas, el mes ronda los 257 dólares. El cálculo es hipotético y los precios cambian, pero el orden se sostiene: el modelo no es la parte cara.
Lo caro son los errores repetidos. Si el 2% de las conversaciones se responde mal y cada una vuelve tres veces, son 24 conversaciones diarias de retrabajo humano y, peor, clientes que aprendieron a no confiar. La inversión que más rinde no es bajar el precio del token: es el set de evaluación que evita que ese 2% llegue a producción.
7.Cómo desplegar sin apostar la operación
El despliegue de un agente se parece más a un cambio de proceso que a un deploy de software. Estos siete pasos son el mínimo para que el sistema aguante un lunes con el doble de volumen.
- Definí el criterio de éxito antes de escribir el prompt: por ejemplo, resolver el 80% de 200 casos reales sin intervención, con cero datos inventados.
- Armá el set de evaluación con los casos feos —reclamos, datos faltantes, insultos, audios transcritos—, no con los tres ejemplos que ya funcionan.
- Poné techo de gasto y de pasos por conversación y por día. Si el sistema no puede gastar más, no puede fundirte un domingo.
- Registrá cada paso con id de conversación, herramienta, tokens y decisión. Sin ese log, diagnosticar es adivinar.
- Corré canary al 10% durante dos semanas y compará contra el resto del tráfico, no contra una sensación.
- Escribí el runbook de tres pasos (verificar, apagar, avisar) y designá quién está de guardia y en qué horario.
- Probá el apagado en un entorno real antes de necesitarlo: un flag que nadie ejercitó no es un flag, es una intención.
8.Cuándo no conviene llevar un agente a producción
Hay tres casos en los que el agente debería quedarse en asistente interno. El primero: nadie disponible para mirar el tablero ni apagarlo, porque un agente autónomo sin guardia es un riesgo que se paga con un cliente. El segundo: el proceso cambia todas las semanas, y cada cambio deja el set de evaluación desactualizado antes de terminarlo.
El tercero, el más importante: cuando el error es irreversible. Un agente que resume reuniones se equivoca y alguien lo corrige; un agente que emite una nota de crédito o cancela un envío no tiene marcha atrás. En esos casos conviene que proponga la acción y que una persona la ejecute, al menos hasta tener meses de historial limpio.
Preguntas frecuentes
¿Cuánto tarda poner un agente en producción?
Entre dos y seis semanas si el proceso ya está definido y las herramientas existen. Lo que más demora no es el modelo: es conectar los datos, armar el set de evaluación con casos reales y escribir las reglas de derivación y de gasto.
¿Necesito un equipo de machine learning?
No. Necesitás alguien que pueda leer logs, entender una API y mirar métricas. El trabajo fino es de operación y de producto: qué casos probar, qué se considera un error y a quién avisar cuando algo falla.
¿Cómo evito que el agente invente datos?
Dándole herramientas que devuelvan datos verificables y prohibiéndole responder de memoria sobre stock, precios o plazos. Si la herramienta falla, la respuesta correcta es «no puedo confirmarlo ahora», no una estimación.
¿Qué pasa si el proveedor del modelo cambia el precio o lo retira?
Se resuelve con dos decisiones de arquitectura: el modelo se elige por configuración y no hardcodeado en el código, y el set de evaluación se guarda para poder comparar el proveedor nuevo contra el anterior con los mismos casos.
¿Se puede tener un agente en producción sin guardia humana?
Solo para tareas sin consecuencias y con volumen bajo, por ejemplo un resumen interno que alguien lee antes de usar. Si el agente responde a clientes, cobra o modifica datos, hace falta alguien que pueda apagarlo en minutos.
Fuentes
- Gartner — Over 40% of Agentic AI Projects Will Be Canceled by End of 2027 (25 de junio de 2025).
- McKinsey — The State of AI 2025: Agents, innovation, and transformation (noviembre de 2025): 62% de las organizaciones al menos experimenta con agentes y 23% escala alguno en toda la empresa.
- Fortune — MIT report: 95% of generative AI pilots at companies are failing, sobre The GenAI Divide: State of AI in Business 2025 (MIT NANDA, julio de 2025).
- Google — Site Reliability Engineering: Embracing Risk (prácticas de confiabilidad y presupuesto de error).
- NIST — AI Risk Management Framework (marco de gestión de riesgos de IA).