1.Qué es la inteligencia artificial, en una frase
La inteligencia artificial es un conjunto de programas que resuelven tareas que antes requerían una persona: reconocer una cara, traducir un texto, decidir si un mail es spam, conducir un auto. No hay una sola tecnología detrás: son familias de técnicas distintas, y la que domina hoy se llama aprendizaje automático.
La definición clásica, la de Wikipedia, habla de sistemas que perciben su entorno y actúan para lograr objetivos. Lo importante para un principiante es la parte que suele quedar implícita: la máquina no entiende. Encuentra patrones en datos y los aplica a casos nuevos.
Esa diferencia evita dos errores simétricos. El primero es creer que la IA «piensa» y confiarle decisiones que necesitan criterio. El segundo es creer que es una moda y que no va a cambiar nada: el AI Index 2026 de Stanford mide 88% de adopción en organizaciones, y la IA generativa atrajo US$33.900 millones de inversión privada en 2024, 18,7% más que el año anterior.
2.Los cuatro conceptos que alcanzan para entender casi todo
Con cuatro palabras se puede leer cualquier nota sobre inteligencia artificial sin perderse: modelo, entrenamiento, inferencia y dato. Todo lo demás son variantes.
| Concepto | Qué es | Ejemplo cotidiano |
|---|---|---|
| Modelo | El programa que quedó después de aprender de los datos | El filtro que decide si un mail va a spam |
| Entrenamiento | El proceso de mostrarle millones de ejemplos para que ajuste sus números internos | Mostrarle 200.000 mails marcados como spam y 800.000 que no lo eran |
| Inferencia | El momento en que el modelo ya entrenado responde a un caso nuevo | Llega un mail y el filtro decide en milisegundos |
| Dato | El material con el que aprendió; si está sesgado, el modelo también | Si en los ejemplos no había mails en guaraní, los va a clasificar mal |
El entrenamiento es la parte caro y lento: puede llevar meses y millones de dólares. La inferencia es la parte barata y rápida: por eso una vez entrenado, el modelo se puede usar millones de veces. Esa asimetría explica el negocio de la IA: se invierte una vez y se vende por uso.
Hay un quinto concepto que conviene sumar aunque no esté en la lista: la ventana de contexto. Es la cantidad de información que el modelo puede tener en cuenta en una misma respuesta. Cuando le pegás un contrato de 40 páginas y te contesta sobre la página 2, está usando la ventana; cuando se olvida de la pregunta inicial, la ventana se llenó.
3.Cómo aprende una máquina: el caso del filtro de spam
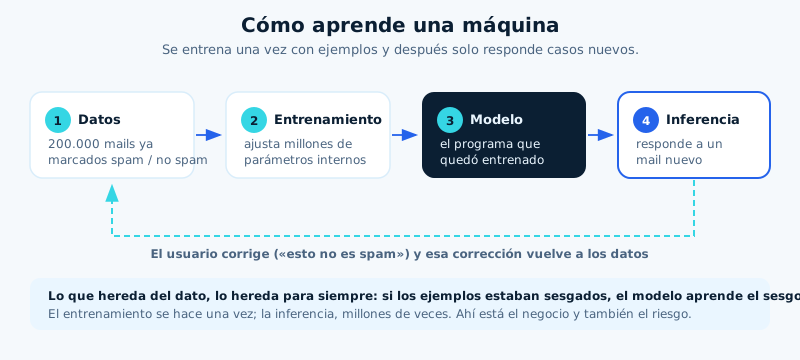
El filtro de spam es el mejor ejemplo para entender el aprendizaje automático porque todos lo vivimos y nadie lo programa a mano. Nadie escribió la regla «si dice premio y urgente, es spam»: el sistema la dedujo de los datos.
Paso 1. Se juntan cientos de miles de mails que los usuarios ya marcaron como spam y otros tantos que no. Esos son los ejemplos etiquetados.
Paso 2. El modelo ajusta sus números internos para que, dado un mail, la probabilidad de acertar sea cada vez mayor. No aprende reglas legibles: aprende una configuración de miles de millones de parámetros que funciona.
Paso 3. Cuando llega un mail nuevo, calcula a qué se parece más y lo clasifica. Si el usuario corrige —«esto no es spam»—, ese dato vuelve al sistema y en el próximo entrenamiento pesa.
Ese mecanismo tiene una consecuencia incómoda: el modelo hereda los sesgos de los datos. Si durante años los usuarios marcaron como spam los mails escritos en portugués, el filtro va a castigar el portugués. No es maldad del algoritmo: es lo que los datos dicen.
Lo mismo pasa con un caso de negocio. Un comercio que usa un modelo para priorizar consultas de clientes, entrenado con el historial de un solo vendedor, va a repetir el criterio de ese vendedor: si él atendía primero a los clientes de mayor ticket, el sistema va a aprender que un cliente chico no vale la pena. El sesgo no está en la máquina, está en el ejemplo que le dieron.
4.Qué puede y qué no puede hacer hoy
La IA actual es muy buena en tareas con patrón y muy mala en tareas con causa. Esa es la línea, y casi todo lo demás se deduce de ahí.
| Tarea | Estado hoy | Por qué |
|---|---|---|
| Reconocer imágenes, voces y textos | Resuelto y barato | Hay millones de ejemplos disponibles para entrenar |
| Traducir y resumir | Muy bueno en idiomas con muchos datos | El patrón es estable y verificable |
| Escribir borradores | Bueno, con revisión | Imita el estilo; no verifica los hechos |
| Predecir demanda o mantenimiento | Bueno si hay historial propio | Necesita datos de tu operación, no sirve el modelo genérico |
| Explicar por qué pasó algo | No confiable | Correlación no es causalidad |
| Decidir con consecuencias | No debería hacerlo solo | No tiene contexto ni responsabilidad |
Un ejemplo que ordena la discusión: un modelo puede detectar con precisión que una máquina va a fallar en los próximos días porque el patrón de vibración se parece al de fallas anteriores. Lo que no puede es decidir si conviene parar la línea ahora o esperar el fin de semana: eso depende del costo, del stock y del cliente, que no están en los datos.
La forma práctica de aplicar la tabla: usá IA donde el resultado se pueda verificar rápido y barato, y reservá la decisión para una persona. Detectar el patrón es tarea de la máquina; decidir qué hacer con él sigue siendo tuyo.
¿Trabajás en un equipo que recién empieza con IA? Escribime y armamos una introducción práctica para tu área.
Escribime un mail5.Dónde la usás sin darte cuenta
La mayoría de la gente ya usa inteligencia artificial varias veces por día sin abrir ninguna herramienta nueva. Reconocerlo sirve para entender qué tipo de tareas resuelve bien y cuáles no.
- El banco. Cuando una compra con tu tarjeta se rechaza «por seguridad», un modelo de detección de fraude la marcó como anómala comparándola con tus patrones.
- El supermercado. La reposición de stock y el pronóstico de demanda de cada sucursal salen de modelos que miran ventas pasadas, clima y feriados.
- El mapa. La ruta y el tiempo estimado combinan tráfico en vivo con un modelo que aprende de millones de viajes.
- El correo y el celular. El filtro de spam, el teclado que sugiere palabras y el reconocimiento de fotos son modelos corriendo en el dispositivo.
- Atención al cliente. El chat que te contesta a las 23 h y te deriva a un humano cuando no entiende es un modelo de lenguaje con reglas de negocio encima.
Hay un patrón en todos los casos: la IA resuelve el paso repetitivo y la persona resuelve la excepción. El banco bloquea automáticamente y te llama si insistís; el chat responde lo frecuente y deriva lo raro. Cuando esa división se rompe —la máquina decide la excepción— aparecen los problemas que salen en las noticias.
6.Los riesgos que importan de verdad
Los riesgos que ocupan titulares —robots que se rebelan— no son los que importan hoy. Los que importan son cuatro, y los cuatro ya están pasando en empresas normales.
Error con seguridad. Un modelo que se equivoca no avisa: entrega el resultado con el mismo tono que cuando acierta. En un presupuesto, en un resumen de contrato o en una ficha de producto, eso significa que alguien tiene que revisar. Si nadie revisa, el error viaja.
Sesgo heredado. Un sistema de selección de personal entrenado con diez años de contrataciones de una empresa va a reproducir los criterios de esos diez años, incluidos los que hoy no se considerarían aceptables. El dato viejo no es neutral.
Datos personales. Todo lo que se pega en un chat público puede quedar registrado. La regla que usan las empresas ordenadas es simple: definir qué categorías de información no salen de la organización y escribirlo.
Pérdida de criterio. El riesgo menos visible es el equipo que deja de saber hacer la tarea porque la delega entera. Si mañana la herramienta cambia de precio o falla, nadie sabe hacer el trabajo a mano. En tareas críticas conviene mantener la versión manual viva.
El marco regulatorio empieza a ordenar esto: el Reglamento Europeo de IA escalona sus obligaciones por nivel de riesgo y ya exige transparencia para contenido generado. Si tu empresa vende en Europa o a clientes europeos, ese calendario es el que fija los plazos.
7.Cómo empezar sin gastar nada
Empezar no requiere presupuesto: requiere una tarea concreta y una semana de paciencia. El orden importa más que la herramienta.
- Elegí una tarea aburrida y repetida. Resumir informes, responder las mismas cinco preguntas, ordenar una planilla. No empieces por la tarea más importante.
- Hacela a mano una vez y cronometrala. Sin ese número no vas a saber si mejoró.
- Probá con una herramienta gratuita y un pedido bien escrito. Contexto, tarea, formato y criterio de aceptación. Si el resultado es malo, mejorá el pedido antes de cambiar de herramienta.
- Revisá la salida y anotá qué corregiste. Esa lista de correcciones es el manual que va a hacer que la segunda vez salga bien.
- Decidí con un número. Tiempo total —incluida la revisión— antes y después. Si el ahorro es menor al 20%, la tarea no era la adecuada.
Un último consejo que ahorra meses: no empieces por la IA más avanzada. Empezá por la tarea más chica que te moleste todos los días. El aprendizaje real no viene de entender qué es un transformer, sino de ver con tus ojos dónde la máquina acierta y dónde inventa.
Preguntas frecuentes
¿Necesito saber programar para usar inteligencia artificial?
No. Las herramientas actuales se usan escribiendo o hablando, y las plataformas de automatización permiten armar flujos sin código. Programar sirve cuando necesitás integrar la IA con un sistema propio o procesar volumen alto; para el uso diario de un equipo, no es un requisito.
¿La IA va a reemplazar mi trabajo?
Reemplaza tareas, sobre todo las repetitivas y verificables: resumir, clasificar, redactar borradores. Los puestos enteros cambian más lento, y lo que suele pasar es que la persona deja de hacer lo mecánico y se queda con el criterio y los casos difíciles. El riesgo real está en los puestos de entrada que se aprendían haciendo esas tareas.
¿Por qué a veces inventa datos?
Porque no busca la respuesta en ningún lado: la genera palabra por palabra según lo que le parece probable. Cuando no tiene el dato, completa el hueco con algo verosímil. La solución práctica es darle la fuente en el mismo pedido o pedirle que busque y cite, y verificar todo número o cita antes de usarlo.
¿Cuánto cuesta empezar?
Cero si se usa un plan gratuito para probar una tarea. Los planes pagos individuales rondan las decenas de dólares por mes y los de equipo se cobran por usuario. El costo real no es la suscripción: es el tiempo de revisar salidas y escribir el conocimiento de la empresa en un formato que la herramienta pueda usar.
¿Qué es la diferencia entre IA, machine learning y IA generativa?
La inteligencia artificial es el campo entero. El aprendizaje automático (machine learning) es la técnica dominante dentro de ese campo: programas que aprenden de datos en lugar de reglas escritas. La IA generativa es un tipo de modelo de aprendizaje automático que produce contenido nuevo —texto, imagen, audio, video— en lugar de clasificar o predecir un valor.
Fuentes
- Wikipedia — Inteligencia artificial (definiciones y campo, consultado en noviembre de 2026).
- Wikipedia — Aprendizaje automático (entrenamiento e inferencia).
- Stanford HAI — AI Index Report 2026: 88% de adopción organizacional.
- Stanford HAI — AI Index Report 2025: US$33.900 millones de inversión privada global en IA generativa durante 2024 (+18,7%).
- EU Artificial Intelligence Act — Calendario de aplicación (consultado en noviembre de 2026).