Cómo filtré 2.572 reviews negativas con Jev


2026-10-03
Cómo filtré 2.572 reviews negativas con Jev en 2 minutos

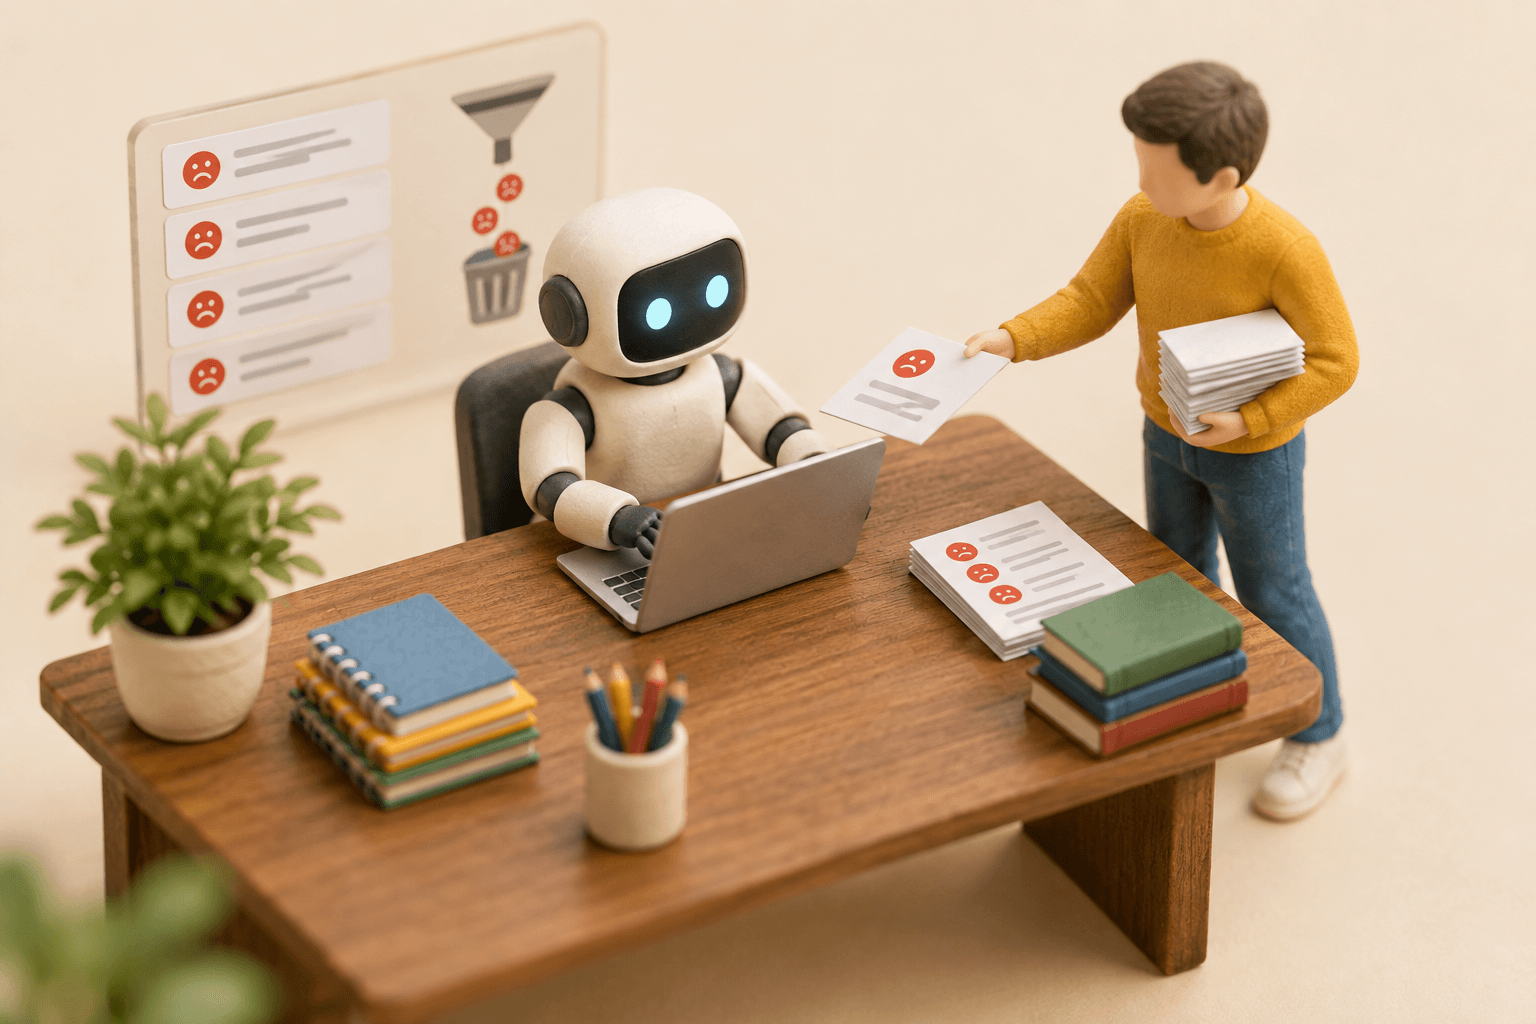
Tenía 2.572 reviews de un cliente y necesitaba separar las negativas para escalar los reclamos. Leerlas a mano no era opción. Con Jev lo resolví en 2 minutos, en 26 lotes de 100.

No escribí código raro. Un POST a la API, una pregunta de sí o no por review, y una regla simple: si la review era negativa o tenía rating 1 o 2, la marcaba.

El problema: 2.572 reviews y cero tiempo

Leer 2.572 reviews lleva días. Y el patrón de un humano es malo para esto: se cansa, se distrae, y para la review 1.500 empieza a aprobar todo o a rechazar todo.

Un LLM tampoco era la respuesta. Pedirle a ChatGPT "leé estas 2.572 reviews y decime cuáles son negativas" no funciona. Te devuelve texto, se trunca, y el output hay que parsearlo.

Necesitaba un veredicto por review, no un resumen.

La setup: Noul "¿es negativa?" más regla de rating

Jev tiene una primitiva para esto: Noul, que devuelve la probabilidad de que algo sea verdadero.

La pregunta fue simple: "¿Es negativa esta review?" Y la combiné con una regla dura: si el rating era 1 o 2, negativa directo, sin preguntarle al modelo. El modelo solo evaluaba las reviews con rating 3 o más, donde la negatividad no es obvia.

Eso ya es una lección: no le pidas al modelo lo que podés resolver con una regla.

Batching: cómo evaluar 100 reviews por llamada

Lo que hizo que tardara 2 minutos y no 20 fue el batching. Jev evalúa N documentos en una sola llamada. Armé el estado como una lista indexada, con una pregunta por índice que referencia el elemento:

state = {"reviews": [{"text": "...", "rating": 4}, ...]}
questions = {"r0": {"type": "noul", "instructions": "¿Es negativa reviews[0].text?"},
             "r1": {"type": "noul", "instructions": "¿Es negativa reviews[1].text?"}}

Una llamada devuelve 100 veredictos con sus probabilidades. 26 lotes, y listo. Con retry y backoff para los errores 429 y 529, que son rate limiting.

Los números del filtro

De las 2.572 reviews, la regla dura de rating atrapó la mayoría de las negativas sin tocar el modelo: las de 1 y 2 estrellas se marcan solas. El modelo quedó para el borde, las de 3 o 4 estrellas con tono negativo, donde la negatividad se esconde en frases como "el producto está bien pero el envío tardó dos semanas".

Ahí es donde Noul brilla. Una review de 4 estrellas que dice "no volvería a comprar" es negativa aunque el número no lo diga. El modelo la captura por el texto, no por el rating.

El resultado fue una lista limpia de negativas, cada una con su probabilidad, lista para ordenar por urgencia y escalar.

El resultado y la lección

De las 2.572, el filtro separó las negativas en minutos. El script quedó como una herramienta reusable: le cambio el CSV y la pregunta, y sirve para cualquier clasificación por lotes.

La lección de fondo es la de Jevons: cuando una decisión se vuelve tan barata y rápida, no la usás menos, la usás más. El costo de 0,042 dólares por millón de tokens no te ahorra una llamada. Te multiplica las decisiones que podés automatizar sin pensarlo dos veces.

Qué necesitás para replicarlo

Tres cosas: la API key de TypeSafe, un CSV con las reviews y una pregunta clara. El batching se arma solo: lista indexada en el estado, una pregunta por índice y un retry con backoff para cuando la API responde 429.

El script es de 50 líneas. La parte difícil no es el código, es elegir bien la pregunta. Una pregunta vaga da probabilidades inútiles. "¿Es negativa?" funciona porque es binaria y concreta. Si tu pregunta no se puede responder con un sí o un no, estás pidiendo mal.

Preguntas Frecuentes

Las dudas que más surgen

1¿Por qué no usé un LLM para filtrar las reviews?

Porque un LLM devuelve texto y hay que parsearlo, y con 2.572 reviews el parsing se vuelve el problema. Jev devuelve una probabilidad por review, directo.

2¿Cuánto tardó en total?

Unos 2 minutos, en 26 lotes de 100 reviews. La clave fue el batching, no la velocidad de cada llamada.

3¿Qué hago con las reviews que caen en la zona gris?

Si la probabilidad cae entre 0.30 y 0.70, la mando a revisión humana. Fuera de esa banda, decido solo.

4¿El script sirve para otras cosas?

Sí. Cambio el CSV y la pregunta, y sirve para clasificar tickets, comentarios o cualquier texto por lotes. Es el patrón Noul más una regla.

Te puede interesar